افهم الأثر الحقيقي للبيانات المنظمة في البحث باستخدام الذكاء الاصطناعي. افصل بين الفوائد الموثقة في Google والفرضيات حول نماذج اللغات الكبيرة (LLMs) ومحركات البحث التوليدية.
Written and published by Blog Post Automatic-O
تساعد البيانات المنظمة التي يتم تنظيمها عبر Schema.org بشكل مباشر في فهم الكيانات والسياق بواسطة محركات البحث وأنظمة البحث بالذكاء الاصطناعي. ومع ذلك، فإن التأكيد على أن البيانات المنظمة تضمن أولوية الاقتباس في الإجابات التوليدية لا يزال يفصل بين الحقائق الموثقة والاستنتاجات الفنية في السوق.
الدور المثبت للبيانات المنظمة في فهم الكيانات
يُستخدم استخدام البيانات المنظمة بصيغة JSON-LD كمترجم صريح لهيكلية الصفحة لزواحف البحث. وفقًا للوثائق الرسمية من Google، فإن الترميزات مثل Article وOrganization وProduct تزيل الغموض عن المصطلحات، مما يتيح للخوارزميات تحديد المؤلفين والتواريخ والموضوعات والعلاقات بين الكيانات في موقعك بدقة.
الفرق بين الحقائق الموثقة واستنتاجات السوق حول البحث بالذكاء الاصطناعي
تؤكد المصادر الرسمية لمحركات البحث أن ترميز Schema يسهل استخراج البيانات، بينما يعتمد الاقتباس في النماذج التوليدية بشكل أساسي على قيمة وأهمية النص العادي. لتنظيم ما هو مثبت وما هو مضاربة في سوق السيو (SEO)، راجع المقارنة الفنية التالية:
| الجانب المقيّم | حقيقة موثقة (مصادر رسمية) | استنتاج / فرضية السوق |
|---|---|---|
| فهم الصفحة | يضمن التصنيف الصحيح للكيانات في بحث Google والمقتطفات المنسقة (rich snippets). | يجعل الصفحة المرجع الرئيسي الإجباري لنماذج اللغات الكبيرة (LLMs). |
| الاقتباس في AI Overviews | تؤكد Google أن الممارسات الجيدة للسيو التقليدي هي الأساس لميزات الذكاء الاصطناعي. | إضافة JSON-LD تجبر على عرض الرابط في الإجابة المنشأة بواسطة الذكاء الاصطناعي. |
| القراءة بواسطة الروبوتات (مثل: OAI-SearchBot) | تقرأ روبوتات الذكاء الاصطناعي كود HTML العام؛ وتتطلب الفهرسة ألا يكون البوت محظورًا في robots.txt. | تستهلك نماذج LLMs طبقة البيانات المنظمة فقط وتتجاهل باقي النص. |
| السلطة الموضوعية | المحتوى المعمق والأصلي ذو الإجابات المباشرة يبني الأهمية. | الترميزات المعقدة تحل محل الحاجة إلى نص تأليفي عالي الجودة. |
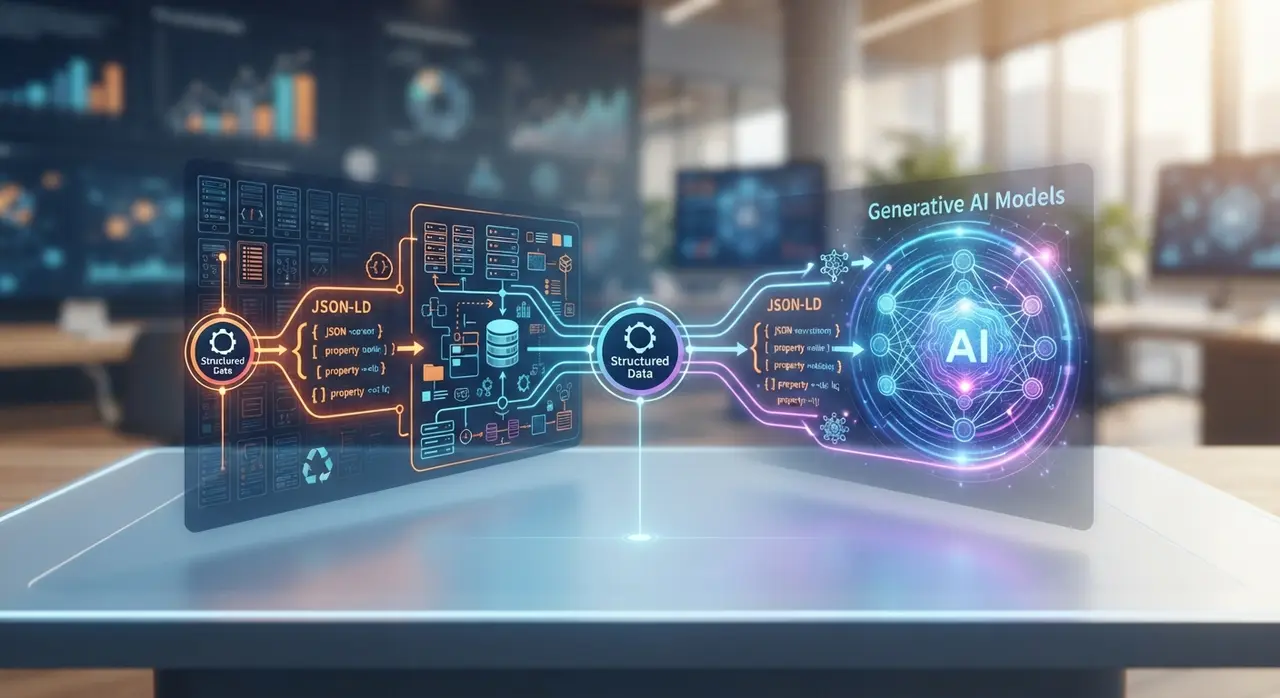
كيف تعالج الروبوتات وأنظمة البحث التوليدية البيانات المنظمة
تحلل أنظمة البحث القائمة على الذكاء الاصطناعي مستند الويب ككل، وتجمع بين البيانات المنظمة ومعالجة اللغة الطبيعية للنص العادي. وعندما تلخص ميزات مثل نظرات عامة على الذكاء الاصطناعي والبحث التوليدي الإجابة، يستلك نموذج اللغة الكتل الدلالية لـ HTML للتحقق مما إذا كانت الصفحة تجيب بشكل مباشر على استفسار المستخدم. يسهل الترميز الفني الاكتشاف، ولكن الفائدة الفعلية للمحتوى هي التي تحدد الإدراج في الإجابة النهائية.
حالة واقعية: الدقة الفنية والمحتوى المعلوماتي في عمليات B2B
واجهت شركة خدمات B2B صعوبات في أن يتم ذكرها في إجابات المساعدين الافتراضيين حول حلول الأتمتة التجارية. ومن خلال دمج الترميز الدقيق للبيانات المنظمة مع خط تحريري مؤتمت بواسطة BlogPost Automático، أصبحت المقالات الفنية للشركة تُعرف كمرجع موثوق. وكانت النتيجة النوعية هي زيادة حجم العملاء المحتملين المؤهلين الجدد عبر الزيارات المجانية واقتباس العلامة التجارية بشكل مكرر في ملخصات البحث حول مجالك المتخصص.
أفضل الممارسات للمواءمة بين البيانات المنظمة وتحسين الذكاء الاصطناعي
تتطلب التلبية الناجحة لـ Schema.org التوافق بين كود الموقع ووضوح النص المرئي للمستمع أو القارئ. إذا كان موقعك يواجه مشكلات في الزحف أو مقالات منشورة لا يتم فهرستها، فيجب أن يسبق التصحيح الفني أي استراتيجية متقدمة للذكاء الاصطناعي. لضمان فعالية استخدام البيانات المنظمة:
- حافظ على الاتساق الفعلي: يجب أن تتطابق البيانات في JSON-LD تمامًا مع النص المرئي في الصفحة.
- اعطِ الأولوية لـ Schema للمقالات (Article) والأسئلة الشائعة (FAQ): سهّل قراءة الأسئلة والأجوبة بواسطة خوارزميات الاستخراج.
- تجنب البيانات القديمة: قم بتحديث ترميزات تاريخ التعديل والتأليف كلما تم تجديد المحتوى.
الأسئلة الشائعة
هل البيانات المنظمة إجبارية للظهور في البحث التوليدي بالذكاء الاصطناعي؟
لا، ليست البيانات المنظمة متطلبًا إجباريًا لاقتباس الصفحة في إجابات الذكاء الاصطناعي. ومع ذلك، فهي تساعد روبوتات البحث على فهم سياق الصفحة وكياناتها بدقة وسرعة أكبر.
هل يقرأ ChatGPT Search كود Schema.org أم نص الصفحات فقط؟
يقرأ ChatGPT Search وروبوتات مثل OAI-SearchBot كود HTML العام لصفحات الويب لاستخراج المعلومات. وجود نص واضح وجيد التنظيم هو العامل الحاسم للاقتباس، بينما يعمل Schema.org كدعم فني.
هل يضمن استخدام ترميز FAQ في JSON-LD المقتطفات المنسقة أو إجابات الذكاء الاصطناعي؟
يزيد استخدام ترميز FAQ من فرص كشف Google وأنظمة البحث لهيكل الأسئلة والأجوبة في الصفحة. لا يوجد ضمان مطلق للعرض في المقتطفات المنسقة أو الملخصات التوليدية، حيث يعتمد القرار النهائي على خوارزمية كل منصة.