Entienda por qué un artículo no se indexa en Google y consulte una guía paso a paso para diagnosticar y resolver problemas de visibilidad orgánica.
Escrito y publicado por BlogPost Automatico
Un artículo no aparece en Google cuando el motor de búsqueda no logró descubrir la URL, fue bloqueado durante el rastreo o evaluó la página como insuficiente para la indexación Google. Para corregir el problema de un artículo no indexado, es necesario identificar en qué etapa del flujo de búsqueda la página quedó retenida.
La diferencia entre descubrimiento, rastreo, indexación y posicionamiento
La causa exacta de que un artículo no se muestre en la búsqueda depende directamente de la fase en la que el robot de Google encontró un obstáculo. Confundir estas etapas hace que los gestores apliquen correcciones erróneas, como reescribir un texto impecable que el robot ni siquiera llegó a visitar.
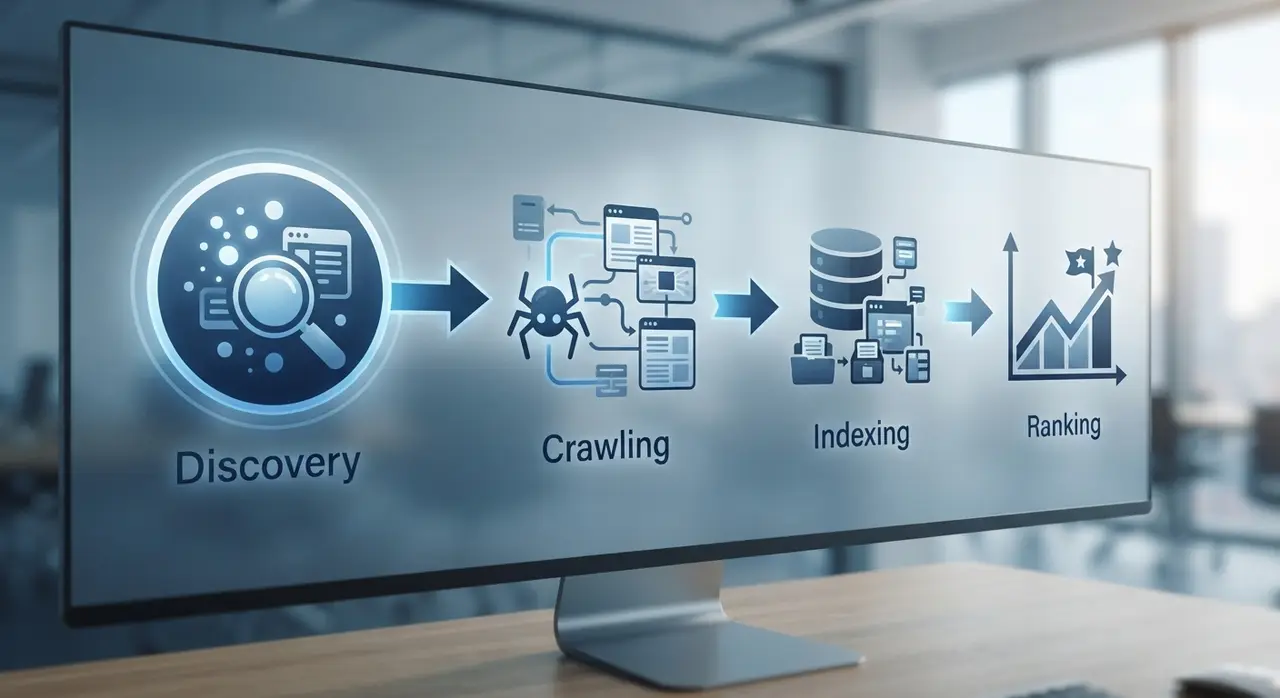
El proceso de búsqueda ocurre en cuatro pasos secuenciales:
- Descubrimiento: Google descubre que la URL existe a través de sitemaps XML o enlaces de otros sitios.
- Rastreo (Crawl): El robot (Googlebot) descarga el código HTML, imágenes y recursos de la página para leer su contenido.
- Indexación: Google analiza la calidad, originalidad y relevancia del contenido y decide si debe meb-almacenarlo en su base de datos oficial.
- Posicionamiento (Ranking): El algoritmo posiciona la página indexada en las respuestas para búsquedas específicas de los usuarios.
Si su artículo no aparece en la búsqueda, el problema está en uno de estos cuatro puntos. Entender esta distinción ahorra horas de rehacer trabajo técnico y editorial.
Diagnóstico técnico: estado HTTP, robots y etiquetas canónicas
Los fallos de configuración técnica en robots o etiquetas de encabezado pueden prohibir explícitamente a Google almacenar una página. Antes de cuestionar la calidad del texto, es indispensable auditarla a nivel de la infraestructura de la web.
Los tres puntos primarios de bloqueo técnico son:
- Código de estado HTTP incorrecto: Si el servidor devuelve códigos como 404 (no encontrado), 403 (prohibido) o 500 (error interno), el robot interrumpirá el procesamiento de la URL.
- Directiva noindex o bloqueo vía robots.txt: Una etiqueta
<meta name="robots" content="noindex">en el encabezado le avisa a Google que desconsidere la página. De la misma forma, una reglaDisallowen el archivorobots.txtpreviene que el robot rastree la dirección. - Etiqueta Canonical apuntando a otra dirección: Si el marcado
rel="canonical"indica otra URL como la versión principal, Google transferirá la autoridad y no indexará el artículo actual.
La siguiente tabla resume cómo estos factores técnicos afectan la presencia de la página:
| Etapa del fallo | Síntoma en Search Console | Causa probable | Acción recomendada |
|---|---|---|---|
| Rastreo | Bloqueada por el archivo robots.txt | Regla Disallow genérica o incorrecta | Ajustar los permisos en el robots.txt de la aplicación |
| Indexación | Excluida por etiqueta 'noindex' | Plugin de SEO o CMS configurado con bloqueo | Eliminar la etiqueta meta noindex de la página afectada |
| Procesamiento | Página alternativa con etiqueta canónica adecuada | La URL apunta la etiqueta canonical a otra página del sitio | Revisar y corregir la etiqueta rel="canonical" en el encabezado |
| Disponibilidad | Error de servidor (5xx) | Inestabilidad en el alojamiento o fallo de código | Estabilizar el servidor y verificar los registros del sistema |
La importancia de la arquitectura de enlaces internos y sitemap XML
Una estructura de enlaces internos deficiente reduce la capacidad del robot para encontrar y priorizar páginas en un sitio. Las páginas huérfanas —aquellas que no reciben ningún enlace de otras páginas internas— raras veces reciben atención del Googlebot.
Mantener un sitemap XML actualizado en Google Search Console garantiza que los nuevos artículos entren en la cola de descubrimiento inmediatamente después de su publicación. Sin embargo, el sitemap es solo una sugerencia: el motor de búsqueda prioriza páginas respaldadas por una buena arquitectura de enlaces internos. Garantizar que cada nuevo artículo reciba menciones contextuales de páginas ya establecidas señala la relevancia temática de ese contenido.
Calidad y utilidad del contenido en la decisión de indexación
Google descarta páginas que no alcanzan un nivel mínimo de originalidad y valor práctico para el usuario. Aunque la página esté técnicamente perfecta, el algoritmo puede optar por no indexarla si evalúa el contenido como superficial, redundante o generado sin diferenciación comercial.
Con las actualizaciones centradas en sistemas de contenido útil (Helpful Content), las colecciones de blogs que publican artículos genéricos se enfrentan al estado de "Rastreada: actualmente no indexada". Para evitar este rechazo editorial, el contenido debe responder directamente a la intención de búsqueda, presentar datos concretos y demostrar autoridad en el tema. Al analizar las causas de un artículo no indexado, la falta de profundidad y la ausencia de Information Gain son frecuentemente las razones ocultas.
Estudio de caso: normalización de indexación en un catálogo editorial B2B
Empresas con catálogos extensos frecuentemente enfrentan estancamiento en el tráfico cuando decenas de páginas publicadas permanecen fuera del índice. Una empresa del sector de servicios B2B notó que el 35% de su blog mantenía el estado de "Descubierta: actualmente no indexada".
Al realizar el diagnóstico, el equipo identificó dos problemas centrales: falta de enlaces internos y textos superficiales generados sin orientación contextual. Al adoptar la plataforma de BlogPost Automático para reestructurar los clusters de temas y optimizar los artículos con información específica de la empresa, la tasa de indexación subió al 98% en seis semanas, resultando en un crecimiento orgánico sustancial sin necesidad de trabajo manual diario.
Cómo usar Google Search Console para identificar la causa exacta
El informe de Indexación de páginas de Google Search Console es la herramienta definitiva para señalar la razón técnica exacta de la ausencia de una URL. Al pegar el enlace completo en la herramienta de Inspección de URL, el sistema muestra el diagnóstico exacto en tiempo real.
Las dos alertas más frecuentes en el informe exigen acciones distintas:
- Descubierta: actualmente no indexada: Google sabe que la página existe, pero aún no ha tenido presupuesto de rastreo (crawl budget) o interés prioritario para visitarla. Solución: mejore los enlaces internos que apuntan a ella y envíe el enlace a través del sitemap.
- Rastreada: actualmente no indexada: Google visitó y leyó la página, pero decidió no meb-almacenarla en el índice. Solución: reescriba el contenido añadiendo valor exclusivo, corrija la estructura del texto y garantice la alineación con la intención del lector.
Preguntas frecuentes
¿Cuánto tiempo tarda Google en indexar un artículo nuevo?
El tiempo de indexación varía de pocas horas a algunas semanas, dependiendo de la autoridad del dominio y de la frecuencia de publicación del sitio web. Los sitios web establecidos con sitemap activo suelen tener nuevas páginas indexadas en hasta 48 horas.
¿Por qué Search Console muestra 'Rastreada: actualmente no indexada'?
Este estado significa que el Googlebot visitó la página, leyendo su contenido, pero concluyó que no agrega suficiente valor para ser incluida en el índice. Esto suele suceder debido a contenido superficial, textos duplicados o falta de relevancia temática dentro del sitio web.
¿El uso de IA en la producción de contenido impide la indexación en Google?
No, Google evalúa la calidad, precisión y utilidad del contenido, independientemente de cómo fue producido. El riesgo ocurre cuando se publica contenido automatizado genérico y sin revisión, lo que activa filtros contra el abuso de contenido a escala.